robots.txt से Block होने के बावजूद Indexed: इसे कैसे ठीक करें तब useful है जब यह real reader या operator को better decision लेने में help करे, सिर्फ isolated SEO tactic add न करे। Arjns-style publishing में page problem explain करे, practical workflow दिखाए, risks बताए और result review करने का repeatable तरीका दे। Robots.txt crawling को नियंत्रित करता है, indexing को नहीं। पहले तय करें कि URL search में दिखना चाहिए, बाहर रहना चाहिए, redirect होना चाहिए, हटना चाहिए या निजी रहना चाहिए; फिर ऐसा signal लगाएँ जिसे Google पढ़ और सत्यापित कर सके।
Blocked URL indexed क्यों रह सकता है
robots.txt का disallow rule compliant crawler को URL fetch करने से रोकता है; वह links, sitemap, redirects या पुराने crawl से ज्ञात URL को search से हटाने का आदेश नहीं देता। Blocked response fetch न होने के कारण उस पर लगा noindex भी पढ़ा नहीं जा सकता। स्थायी fix इच्छित outcome से शुरू होता है: indexable page को crawl होने दें, public लेकिन search से बाहर page को noindex पढ़े जाने तक crawl होने दें, moved resource redirect करें, सच में हटे resource पर 404 या 410 दें और private सामग्री को authentication से सुरक्षित करें।
robots.txt बदलने से पहले कौन-सा evidence रखें
Warning को हर URL unblock करने का आदेश नहीं, classify की जाने वाली state मानें। मौजूदा और लक्ष्य state दोनों समझाने के लिए पर्याप्त evidence सुरक्षित रखें।
- Representative URLs के production response, rendered robots meta, canonical, sitemap membership, internal links और exact matching robots rule दर्ज करें।
- URL discovery को response processing से अलग रखें ताकि URL-only indexed result को crawled content न समझें।
- देखे गए recrawl evidence के आधार पर review date रखें और बार-बार indexing request भेजने की जगह reported canonical तथा index state जाँचें।
Robots और index state की जाँच करें
सबसे पहले user need और search engine signal को अलग करें। User need वह है जो page solve करता है। Search signal वह है जिससे crawlers और ranking systems solution समझते हैं। अगर page सिर्फ signal chase करता है तो thin हो जाता है। अगर reader की help करता है लेकिन structure hide करता है तो discover होना मुश्किल हो सकता है। सही answer clear page, crawlable HTML, precise metadata, useful examples, internal links और measurable follow-up है।
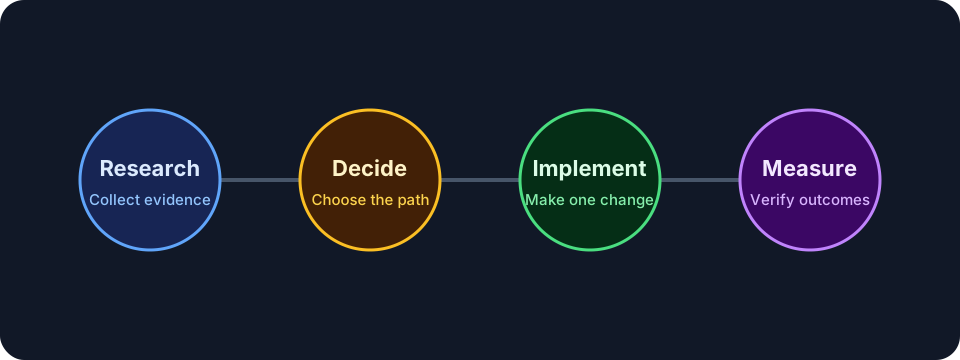
सही removal या access path चुनें
- Page indexing report से प्रभावित URLs export करें और उन्हें template, directory, parameters तथा उद्देश्य के आधार पर समूहों में बाँटें।
- हर समूह के प्रतिनिधि URLs की indexed स्थिति, last crawl, canonical, sitemap और live-test परिणाम दर्ज करें।
- सटीक URL को robots.txt के user-agent groups, wildcard rules, अक्षर case, host, protocol और trailing slash के विरुद्ध जाँचें।
- हर समूह के लिए एक लक्ष्य चुनें: crawl और index, crawl लेकिन noindex, redirect या retire, अथवा authentication से सुरक्षित करना।
- Indexable pages से अनचाहा block हटाएँ, 200 response और consistent canonical रखें तथा sitemap में केवल canonical URLs जोड़ें।
- Public पर non-indexable pages को crawl होने दें, noindex लगाएँ, sitemap से हटाएँ और गैरज़रूरी discovery links कम करें।
- Moved, deleted या private content के लिए robots.txt की जगह permanent redirect, 404/410 या authentication का उपयोग करें।
- Production behavior दोबारा जाँचें और Google के recrawl करके इच्छित स्थिति दिखाने तक निगरानी रखें।
- Publish करने से पहले expected search intent, page promise और verification method document करें।
- Mobile पर rendered page review करें क्योंकि cramped layouts, hidden tables या broken controls good content को poor experience बना सकते हैं।
Blocked URL के लिए decision matrix
यह निर्णय matrix अपनाएँ: public और searchable URL को crawl होने दें, 200 लौटाएँ और canonical URL को sitemap में रखें; public लेकिन search से बाहर URL को crawl होने दें, 200 के साथ noindex दें और sitemap से हटाएँ; moved URL को 301/308 से final URL पर भेजें; हटे URL पर 404/410 दें; confidential content पर authentication अनिवार्य रखें।
- Final article से पहले page brief लिखें।
- Primary query group और reader का next action name करें।
- सिर्फ draft data नहीं, rendered page check करें।
- Verification date record करें ताकि later reporting में context रहे।
Robots और indexing verification checklist
- Title, H1, summary और first section same practical outcome describe करें।
- Page में examples या decision rules हों जिन्हें reader immediately apply कर सके।
- Important links crawlable anchors हों और natural context में हों।
- Sitemap page को तभी include करे जब वह live और canonical हो।
- Page ऐसे claims avoid करे जो visible content या data से verify नहीं होते।
- Editor के लिए review date, publish date और next measurement point clear हों।
वे signals जिन्हें Google fetch कर सके
Decision rules work को honest रखते हैं। Rule page को SEO opinions के collection में बदलने से बचाता है और दूसरे reviewer के लिए review आसान करता है। Rule बताए कि evidence weak हो तो क्या करना है, page thin हो तो क्या करना है, signals conflict करें तो क्या करना है, और कब better data का wait करना safest है।
- अगर page clear reader need answer नहीं कर सकता, उसे indexable content की तरह publish न करें।
- अगर technical signal visible content से conflict करता है, visible content fix करें या signal remove करें।
- अगर section सिर्फ title को अलग words में repeat करता है, उसे example, checklist या caveat से replace करें।
- अगर change verify नहीं हो सकता, उसे completed fix की जगह editorial assumption mark करें।
- Future scheduled page को publish date से पहले public links और sitemaps से बाहर रखें।
robots.txt removal tool कब नहीं है
Customer records, staging environment, invoices, account pages या confidential files को बचाने के लिए robots.txt उपयोग न करें: blocked URLs discover हो सकते हैं और server उन्हें किसी को भी दे सकता है। Authentication या network access control लगाएँ। Infinite facets या parameters पर crawl paths और generation नियंत्रित किए बिना केवल noindex दिखाने के लिए सब unblock न करें। Urgent temporary hide में removal request मूल fix के साथ काम कर सकती है, उसकी जगह नहीं लेती।
समस्या बनाए रखने वाले robots.txt fixes
- Robots.txt block रहते हुए noindex जोड़ना, जिसे Googlebot पढ़ ही नहीं सकता।
- Robots.txt को privacy या security control समझना।
- Page समझने के लिए आवश्यक CSS या JavaScript को block करना।
- Production rule बदलने से पहले ही fix validate करना।
- URL के index होने का कारण समझे बिना discovery links हटाना।
Recrawl और index-state change की पुष्टि करें
इस work को short feedback loop से measure करें: crawl status, sitemap visibility, intended query group impressions, snippets change होने पर clicks/CTR, page engagement और reader related guide या tool तक जाता है या नहीं। Single day data से success judge न करें; search systems, crawling और reporting अलग timelines पर move करते हैं।
Robots और indexing verification checklist: release checks
- Canonical URL, title, meta description, headings और language alternates confirm करें।
- Mobile और desktop पर page open करके spacing, tables, diagrams और code blocks check करें।
- Page sitemap में तभी appear करे जब वह live हो।
- Images में useful alt text हो और layout shift न create करें।
- Related guides से internal links destination page public होने के बाद add करें।
Recommendation: outcome के अनुसार control चुनें: AI review prompt
इस prompt को real URL, draft या crawl export के साथ use करें। Output को review करके ही publish करें, क्योंकि SEO में context और business priority दोनों जरूरी होते हैं।
Careful SEO implementation reviewer की तरह काम करें.
Page/topic: robots.txt से Block होने के बावजूद Indexed: इसे कैसे ठीक करें
URL or draft: [URL or content]
Search intent: [intent]
Review करें: crawlability, title, meta description, headings, content depth, examples, internal links, structured data/canonical needs, mobile UX और measurement plan.
Exact page sections के साथ prioritized fixes return करें.
अक्सर पूछे जाने वाले सवाल
क्या robots.txt indexing रोक सकता है?
नहीं। यह crawler को URL fetch करने से रोकता है, लेकिन किसी दूसरे स्रोत से मिला URL फिर भी index हो सकता है।
क्या blocked page पर noindex लगाना चाहिए?
Block रहते हुए नहीं। noindex पढ़ने के लिए Googlebot को response crawl करना आवश्यक है।
क्या यह warning हमेशा नुकसानदायक है?
नहीं। पहले तय करें कि URL को search में दिखना चाहिए या नहीं।
क्या temporary removal स्थायी समाधान है?
नहीं। मूल crawl, index, redirect, deletion या access rule ठीक करना होगा।
Recommendation: outcome के अनुसार control चुनें
अच्छा SEO page सिर्फ keyword optimized नहीं होता। वह crawlable, useful, readable और honest होता है। Publish करने से पहले rendered page, snippet fields, internal links, indexability और reader action को साथ में check करें।
Page को तब revisit करें जब search intent बदले, product या platform बदले, Search Console नए query groups दिखाए, या users बार-बार clarification मांगें। Content refresh page को ज्यादा accurate और useful बनाए; यह cosmetic date change नहीं होना चाहिए।